

Mac 記憶體唔夠跑 AI?神人靠一條 USB-C 串接 iPhone 分擔運算 長文讀取速度即時飆升 44%
|
Fung Chun Man,
張文乃
| 06-10-2026 16:19 |
在Google
追蹤《e-zone》
追蹤《e-zone》

開發者釋出開源專案 Backburner,透過 USB-C 數據線連接 iPhone 與 Mac 協同運行 27B 等級大語言模型。該專案採用流水線機制拆分模型網絡層數,實測顯示長文本讀取速度最多提升 44%,上下文長度上限擴展至 128K 以上,並支援 8GB 記憶體 Mac 跨裝置載入大型模型。
即刻【按此】,用 App 睇更多產品開箱影片
跨裝置協作突破 Mac 記憶體限制:iPhone 變成 AI 算力與快取延伸
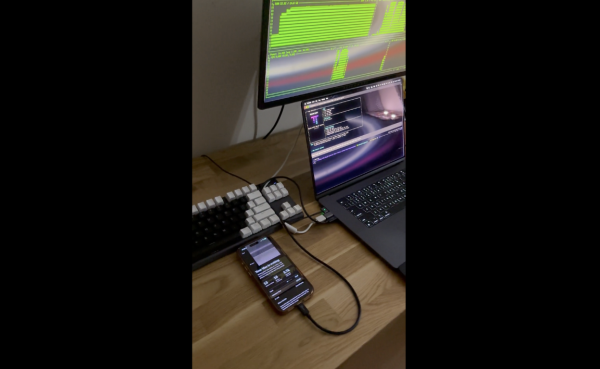
對不少本機運行大型語言模型(LLM)的用戶而言,設備記憶體(RAM)往往是決定模型大小與上下文長度的主要瓶頸。開發者 StayLameBro 近日在 GitHub 上釋出開源專案 Backburner 的首個預覽版 v0.0.1,並於 Reddit 發佈測試報告。該專案透過一條 USB-C 數據線將 iPhone 與 Mac 連接,成功實現兩台裝置協同運行 27B(270億參數)等級的 AI 模型,令長文讀取速度最多提升 44%。
採用工廠流水線分工機制:拆分模型層數與併行計算
Backburner 的核心運作機制是將模型的神經網絡層數拆分至不同硬體執行。以測試所用的 Qwen 3.8-27B 模型為例,該模型共包含 64 層網絡結構:
Mac GPU 職責:負責運算模型前 40 層。
iPhone 職責:接手處理第 41 至 64 層。
為了避免裝置間出現等待停頓,Backburner 引入「工廠流水線」處理機制。系統會將輸入的 Prompt 切分成每批 256 個 Token 的區塊。當 Mac 完成第一批資料的前 40 層運算後,會立即經由 USB-C 將數據傳送至 iPhone 進行後續 24 層運算,同時 Mac 則同步開始處理第二批資料的前 40 層。這種跨裝置併行運算架構,有效提升了整體處理效率。
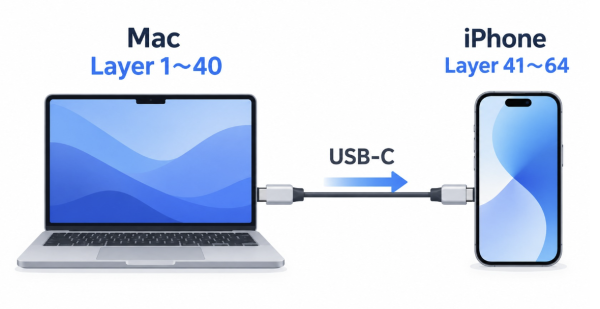
由於兩台裝置間需進行頻繁的數據傳輸,數據線頻寬成為關鍵要素。開發者指出,測試時必須使用 10Gb/s 的 USB-C 傳輸線(如 USB 3.2 Gen 2 或 Thunderbolt 標準),若採用 iPhone 原廠隨盒附送的 USB 2.0 規格線材,傳輸瓶頸將導致系統效能大幅下降。
Prefill 階段實測數據:長文字讀取速度提升顯著
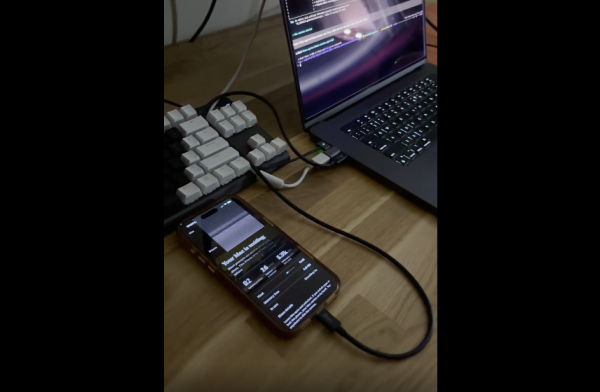
在效能測試方面,實驗環境採用配備 24GB 統一記憶體的 M4 Pro MacBook Pro,搭配 iPhone 17 Pro Max,透過 10Gb/s USB-C 線材連接,運行 Qwen 3.8-27B 模型。
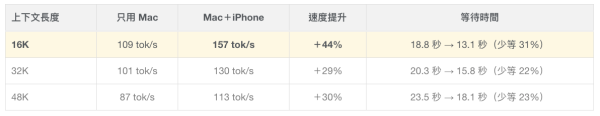
測試數據顯示,iPhone 的算力加入能顯著縮短模型讀取長篇 Prompt 的 Prefill(預填)時間:
16K 上下文長度:讀取速度提升 44%
32K 上下文長度:讀取速度提升 29%
48K 上下文長度:讀取速度提升 30%
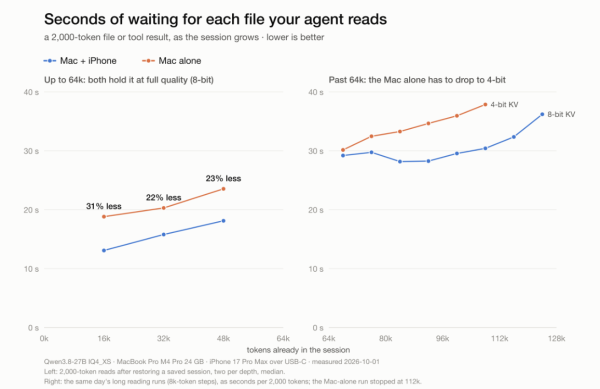
AI 代理工具實際應用情境
在更接近日常工作流程的 AI 代理(AI Agent)實測中,處理一個約 2.7 萬 Token 的新工作階段:
原版 llama.cpp:首次回應等待時間為 245 秒。
Backburner 修改版(僅 Mac):首次回應等待時間縮短至 228 秒。
Backburner 修改版(Mac + iPhone):首次回應等待時間降至 168 秒(比原版減少近 80 秒)。
後續連續對話:平均等待時間由 19.2 秒下降至 14.5 秒。
測試結果證實,此架構在實際應用場景中能切實降低用戶的等待時間。
KV Cache 轉移機制:有效紓緩 Mac 記憶體壓力
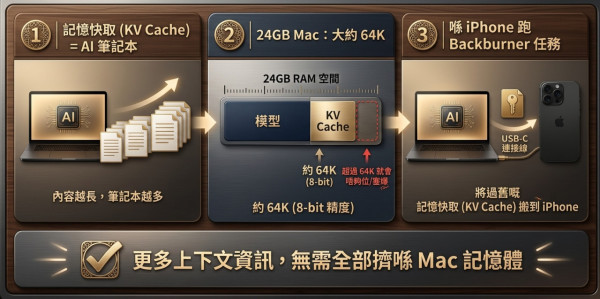
當處理的上下文長度超過 6.4 萬(64K)Token 時,Backburner 會自動調整運算策略,將 iPhone 的角色轉換為「外部記憶體快取與處理單元」。
AI 模型在解析長文本時會產生 KV Cache(鍵值快取)資料。上下文越長,KV Cache 佔用的記憶體空間越大。對於 24GB 記憶體的 Mac 而言,載入 27B 模型後,剩餘空間通常僅足夠保存約 64K 的 8-bit KV Cache。
在 Backburner 架構下,Mac 會獨立執行完整模型的運算,並將較舊的 KV Cache 資料轉移至 iPhone 進行儲存與處理,藉此減輕 Mac 的記憶體負擔。實測結果如下:
8-bit KV Cache:上下文支援上限由純 Mac 的 64K 提升至 128K。
4-bit KV Cache:上下文支援上限可達 140K。
理論最大值:透過動態調配,上下文上限理論上可擴展至約 20 萬 Token。
Split Decode 模式:打破 8GB Mac 運行大模型門檻
除了提升效能與擴充上下文外,Backburner 後續更新中加入的 Split Decode 模式,進一步降低了運行大型模型的硬體門檻。
在該模式下,系統同樣將模型拆分由 Mac 與 iPhone 共同負擔(Mac 負責前半層數,iPhone 負責後半層數及最終輸出)。實測顯示,即使是僅配備 8GB 記憶體的入門款 Mac,亦能在 iPhone 的協助下成功運行原本無法載入的 Qwen 3.8-27B 模型。
雖然在此配置下,文字生成(Decode)速度約為 3.9 Token/s,速度相對較慢,但該專案成功驗證了透過跨裝置資源整合,讓低記憶體設備突破硬體限制運行大參數 AI 模型的可行性。
Source: ezone.hk、KOCPC
【相關報道】
【相關話題】鴨寮街幾十蚊散件砌AI機械人 接入 Muse AI 可聽廣東話 + 以本人聲線回應
網民於 Threads 分享將桌面機械人 StackChan 接入 Muse 及 Gemini 3.8 Flash TTS 模型,成功以複製的個人聲線及廣東話進行對答。本文整理 Muse Gadgets SDK 與 Gemini TTS 語音合成的整合步驟,介紹由 ESP32 開發板韌體刷寫、App 配對,到聲線複製及音訊輸出的基本流程,並列出硬件選購、API 使用費用與私隱條款等注意事項。

Source: ezone.hk